💡 Die wichtigsten Erkenntnisse
- Grundprinzip: Die KI-Rauschunterdrückung nutzt Deep Learning zur Quellentrennung (Source Separation) und geht damit über die einfache Frequenzsubtraktion herkömmlicher ENC-Verfahren hinaus.
- Leistungssprung: Während herkömmliche Verfahren eine konstante Rauschreduzierung von etwa 15 dB erreichen, können KI-Algorithmen eine dynamische Unterdrückung von bis zu 40 dB erzielen und damit die Audioqualität bei der Videoproduktion erheblich verbessern.
- Zentraler Vorteil: Durch das Erkennen individueller „Stimmprofile“ kann KI menschliche Sprache identifizieren und isolieren, während sie gleichzeitig wechselnde Hintergrundgeräusche wie Sirenen oder Gespräche unterdrückt.
- Technologische Entwicklung: On-Device-KI-Chips reduzieren die Latenz und lösen damit ein wesentliches Problem bei Livestreams und Online-Meetings.
Ob bei Podcast-Aufnahmen, Online-Meetings oder der täglichen Kommunikation – klarer und sauberer Klang ist die Grundlage für eine effektive Verständigung. Die Realität ist jedoch voller Störgeräusche: das geschäftige Treiben in einem Café, der Straßenverkehr oder das Klappern von Tastaturen im Büro können die Audioqualität erheblich beeinträchtigen. Nutzer von drahtlosen Mikrofonen suchen deshalb seit Langem nach effektiven Lösungen. Herkömmliche Technologien stoßen jedoch in komplexen Umgebungen häufig an ihre Grenzen, wenn es darum geht, eine wirksame Geräuschunterdrückung mit einer natürlichen Stimmwiedergabe zu verbinden.
Mit dem Einsatz künstlicher Intelligenz (KI) verändert sich heute unser Verständnis von Geräuschunterdrückung grundlegend. Es geht nicht mehr nur darum, Störgeräusche zu „entfernen“, sondern darum, Klänge intelligent zu „verstehen“ und Audiosignale auf eine völlig neue Weise zu verarbeiten. Das Ergebnis ist ein deutlich klareres und natürlicheres Hörerlebnis.
Warum herkömmliche ENC-Verfahren in realen Umgebungen an ihre Grenzen stoßen
So funktioniert die Technologie
Wenn von Geräuschunterdrückung die Rede ist, denken viele zunächst an Environmental Noise Cancellation (ENC) oder Digital Signal Processing (DSP). Diese Technologien spielen bereits seit Jahrzehnten eine wichtige Rolle in der Audiotechnik. Ihr Funktionsprinzip ist vergleichsweise einfach: Mikrofone erfassen Umgebungsgeräusche, während voreingestellte Algorithmen oder Filter bestimmte Frequenzbereiche im Audiosignal erkennen und gezielt herausfiltern.
In der Audiotechnik gehören die Spektralsubtraktion (Spectral Subtraction) und die Wiener-Filterung (Wiener Filtering) zu den verbreiteten herkömmlichen Verfahren. Sie sind in erster Linie auf stationäre Störgeräusche ausgelegt – also auf gleichmäßige Geräusche wie das Brummen eines Ventilators oder einer Klimaanlage. Durch die Analyse der spektralen Eigenschaften dieser konstanten Geräusche versucht das System, das entsprechende Rauschspektrum aus dem gesamten Audiosignal herauszurechnen.
Warum herkömmliche Rauschunterdrückung Sprache nicht zuverlässig von Störgeräuschen trennen kann
Bei gleichmäßigen Hintergrundgeräuschen funktionieren diese Verfahren durchaus effektiv. Ihr Ansatz der Frequenzsubtraktion hat jedoch deutliche Grenzen. Aus technischer Sicht können sie die Schallquelle nicht wirklich „verstehen“ und somit nicht zuverlässig zwischen der gewünschten Stimme und störenden Geräuschen unterscheiden. Stattdessen wenden sie passive Frequenzfilter auf das gesamte Audiosignal an.
Dieser undifferenzierte Ansatz stößt in komplexen Alltagssituationen schnell an seine Grenzen:
- Probleme mit nichtstationären Störgeräuschen: Herkömmliche Verfahren haben Schwierigkeiten mit plötzlich auftretenden und schnell wechselnden Geräuschen, beispielsweise Tastaturanschlägen, Autohupen oder mehreren gleichzeitig sprechenden Personen im Hintergrund.
- Beeinträchtigung der Stimmqualität: Da Sprache und Störgeräusche nicht präzise voneinander getrennt werden können, beschädigen herkömmliche Filter häufig die harmonische Struktur der menschlichen Stimme. Das Ergebnis klingt dünn, dumpf oder sogar „robotisch“ beziehungsweise „unter Wasser“ – ein inakzeptabler Kompromiss für anspruchsvolle Content Creator.
Einfach ausgedrückt ähnelt die herkömmliche Rauschunterdrückung einem groben Rückschnitt: Sie kann offensichtliches Unkraut entfernen, hat aber Schwierigkeiten, störende Elemente zu beseitigen, ohne dabei die eigentliche Pflanze – in diesem Fall die Stimme – zu beschädigen. Genau dieses Dilemma der Frequenzsubtraktion schafft den Raum, in dem KI-gestützte Geräuschunterdrückung ihre Stärken ausspielen kann.
Wie funktioniert KI-Geräuschunterdrückung? Von der Filterung zur Sprachtrennung
Während herkömmliche Rauschreduzierung auf Subtraktion basiert, stellt die KI-Geräuschunterdrückung eine entscheidende technologische Weiterentwicklung dar. Anstatt sich auf einfache Filterverfahren zu beschränken, ermöglicht sie mithilfe von Deep Learning eine intelligente Analyse und Trennung von Sprach- und Hintergrundgeräuschen. So werden Störgeräusche reduziert, während die natürliche Klangqualität der Stimme erhalten bleibt.
Das technische Grundprinzip: Deep Learning und Quellentrennung
Das Herzstück der KI-Rauschunterdrückung ist ein grundlegender technologischer Wandel: weg von regelbasierten Signalverarbeitungsverfahren und hin zu intelligentem Lernen mithilfe von Deep Neural Networks (DNN). KI-Systeme werden mit umfangreichen Datensätzen aus menschlicher Sprache und verschiedenen Störgeräuschen trainiert. Diese umfassen unterschiedliche Sprachen, Akzente und akustische Umgebungen, sodass das System die komplexen Muster zur Unterscheidung von Sprache und Hintergrundgeräuschen erlernen kann.
Im Mittelpunkt des KI-Trainings steht die Frage: „Was ist menschliche Sprache?“ Das System erkennt charakteristische harmonische Strukturen, Tonhöhen und Sprachmuster – ähnlich einem individuellen „Stimmfingerabdruck“. Technisch betrachtet ähnelt die KI-Rauschunterdrückung damit der Quellentrennung (Source Separation): Ein gemischtes Audiosignal wird intelligent in separate Sprach- und Hintergrundgeräuschkomponenten zerlegt.
Ein Blick auf die KI-Geräuschunterdrückung: Wie Geräusche erkannt und entfernt werden
Die KI-gestützte Rauschunterdrückung ist ein intelligenter Prozess, der aus mehreren aufeinanderfolgenden Schritten besteht:
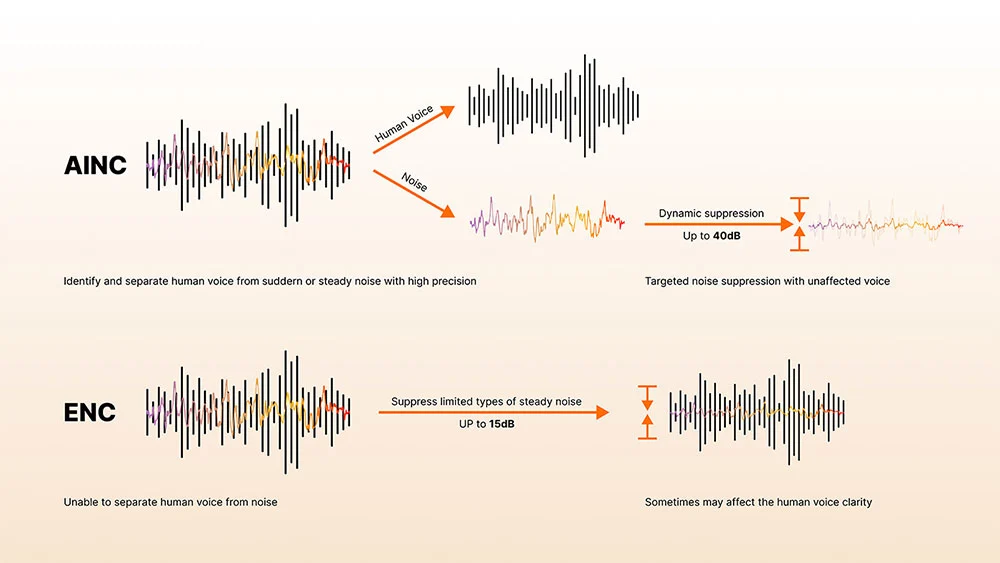
- Erkennung von Sprachmustern: Das Modell analysiert das Eingangssignal in Echtzeit und identifiziert komplexe Muster menschlicher Sprache, darunter Grundfrequenzen und Resonanzen.
- Echtzeit-Klassifizierung: Innerhalb weniger Millisekunden klassifiziert die KI die einzelnen Signalabschnitte präzise als gewünschte Stimme oder Hintergrundgeräusch.
- Gezielte Geräuschunterdrückung: Nach der Klassifizierung wendet das System eine dynamische Unterdrückung ausschließlich auf die Hintergrundgeräusche an, während die gewünschte Stimme möglichst unverändert bleibt. Dies ist besonders beim Livestreaming entscheidend, damit der Sprecher stets im Mittelpunkt steht.
Was bedeutet „Deep Noise Reduction“ wirklich für die Audioqualität?
Dezibel (dB) sind die entscheidende Maßeinheit zur Bewertung der Geräuschunterdrückung. Der Sprung von herkömmlichen 15 dB auf bis zu 40 dB durch KI stellt aufgrund der logarithmischen Skala einen erheblichen Leistungszuwachs dar. Obwohl KI Artefakte wie den bei herkömmlichen Algorithmen häufig auftretenden „Unterwasserklang“ deutlich reduzieren kann, können bei extrem hohen Unterdrückungsstufen weiterhin leichte Artefakte entstehen. Durch intelligente Kompensationsmechanismen sorgt KI jedoch dafür, dass die Stimme klar und natürlich bleibt und ein ausgewogenes Verhältnis zwischen Geräuschunterdrückung und Schutz der Audioqualität erreicht wird.
Die Weiterentwicklung des KI-Hörens: Neue Möglichkeiten für die Echtzeit-Audioverarbeitung
Herausforderung nichtstationärer Störgeräusche
Störgeräusche in der realen Welt sind häufig dynamisch und unvorhersehbar (nichtstationäre Störgeräusche). Dazu gehören beispielsweise Windgeräusche bei Videoaufnahmen, Verkehrshupen oder klapperndes Geschirr. Herkömmliche Technologien verfügen nicht über die notwendige Echtzeit-Analysefähigkeit, um mit solchen wechselnden Geräuschmustern zuverlässig umzugehen. KI-Algorithmen hingegen können Audiosignale kontinuierlich analysieren und durch leistungsfähige Echtzeit-Inferenz unmittelbar auf unvorhersehbare, kurzzeitige Störgeräusche reagieren. Dadurch bleibt die Stimme stets deutlich hörbar.
Die Konzentration auf das Wesentliche
Zwischen Voice Isolation und herkömmlicher ENC besteht ein wesentlicher Unterschied. Während ENC die Gesamtlautstärke der Umgebungsgeräusche reduziert, kann die KI-gestützte Sprachisolierung die gewünschte Stimme gezielt aus einer komplexen Geräuschkulisse herausfiltern. Das ist besonders bei Online-Meetings, Podcast-Aufnahmen und Interviews vor Ort von Vorteil, da sich der Sprecher selbst dann klar hervorhebt, wenn im Hintergrund weitere Personen sprechen.
Der Aufstieg der On-Device-KI
Die Weiterentwicklung von On-Device-KI-Chips hat bisherige Grenzen bei der Signalverarbeitung für drahtlose Mikrofone überwunden. Moderne Audiogeräte integrieren spezielle KI-Prozessoren, die komplexe Algorithmen direkt auf dem Gerät ausführen. Dadurch kann eine leistungsstarke Geräuschunterdrückung mit extrem geringer Latenz erfolgen – eine entscheidende Voraussetzung für Livestreams und Echtzeitgespräche.
Wie KI-Geräuschunterdrückung die Aufnahmequalität und Workflow-Effizienz verbessert
Von „Nachbearbeitung erforderlich“ zu „Professioneller Klang direkt vor Ort“
Bei der Videoproduktion kann die nachträgliche Bereinigung von Audiospuren sehr zeitaufwendig sein. Hochwertige KI-Audioverarbeitung reduziert den manuellen Aufwand zur Korrektur von Stimmverzerrungen erheblich. Dadurch können sich Content Creator stärker auf ihre Inhalte konzentrieren. Der Workflow von der Live-Aufnahme bis zum fertigen Schnitt wird effizienter und eröffnet neue kreative Möglichkeiten.
KI mit guten Aufnahmegewohnheiten kombinieren
So leistungsfähig KI auch ist, sie ist keine Zauberlösung. Profis wissen, dass keine Technologie eine solide Aufnahmebasis ersetzen kann. KI-Rauschunterdrückung ist ein Werkzeug zur Verbesserung der Signalqualität, ersetzt jedoch keine guten Aufnahmetechniken mit drahtlosen Mikrofonen.
- Mikrofonpositionierung: Achten Sie darauf, dass das Mikrofon korrekt ausgerichtet ist und sich in einem angemessenen Abstand zur Schallquelle befindet.
- Windschutz: Verwenden Sie bei Außenaufnahmen geeignete Windschutze, um physikalisch bedingte Störgeräusche zu reduzieren.
- Verstärkungsregelung: Stellen Sie den Gain korrekt ein, um Übersteuerungen oder ein übermäßig hohes Grundrauschen zu vermeiden.
Wie es in der Audiobranche heißt: „KI verbessert das Signal, kann aber eine schlechte Aufnahme nicht reparieren.“ KI ist das i-Tüpfelchen, kein Ersatz für eine professionelle Aufnahmetechnik.
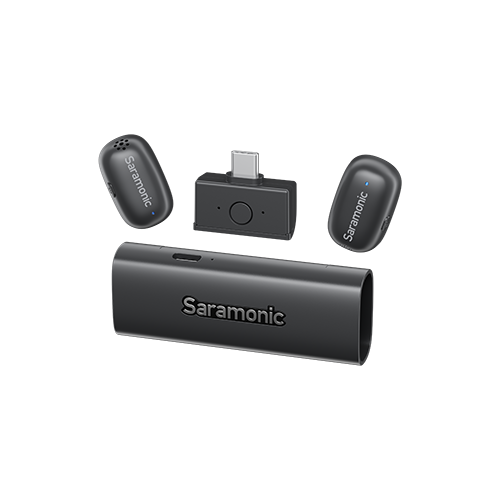
Saramonic Air SE – Professionelle KI-Geräuschunterdrückung für die Hosentasche
Wenn KI-Geräuschunterdrückung das „Gehirn“ moderner Audioverarbeitung ist, dann ist das Saramonic Air SE ein hervorragendes Beispiel dafür, wie sich diese Technologie in einem besonders kompakten Gerät umsetzen lässt.
Integrierter KI-Chip: Ein Durchbruch bei der hardwarebasierten Signalverarbeitung
Anders als Einsteiger-Funksysteme, die auf einfache Softwarefilter setzen, verfügt das Air SE über einen echten On-Device-KI-Prozessor. Der zugrunde liegende Algorithmus wurde mit mehr als 700.000 Geräuschproben und über 20.000 Stunden Deep-Learning-Training entwickelt. Dadurch kann das drahtlose Mikrofon ähnlich wie ein menschliches Gehirn arbeiten: Es erkennt und isoliert individuelle „Stimmprofile“ in komplexen akustischen Umgebungen in Echtzeit und erreicht eine branchenführende Geräuschunterdrückung von bis zu 40 dB.
Intelligente Geräuschunterdrückung mit zwei Modi: Präzision für jede Situation
Das Air SE bietet ein zweistufiges KI-System zur Geräuschunterdrückung, mit dem Vlogger und Livestreamer die Kontrolle über ihre akustische Umgebung behalten:
- Leichter Modus: Ideal für Innenräume. Er reduziert dezente Störgeräusche von Ventilatoren oder Klimaanlagen, während eine natürliche Klangatmosphäre erhalten bleibt.
- Starker Modus: Entwickelt für anspruchsvolle Außenbedingungen. Ob dichter Straßenverkehr, starker Wind oder Baulärm – dieser Modus sorgt dafür, dass Ihre Stimme selbst in besonders lauten Umgebungen klar und deutlich verständlich bleibt.
Ultraleichtes Design mit nur 5 g: Leistungsstarke Technologie ohne zusätzliches Gewicht
Trotz seiner leistungsstarken KI-Funktionen wiegt der Sender des Air SE gerade einmal 5 g. Für Content Creator, die ein hochwertiges Mikrofon für Vlogs suchen, bietet das Air SE die ideale Kombination aus Mobilität und professioneller KI-gestützter Sprachisolierung. Am Kragen werden Sie es kaum spüren – den Unterschied in Ihren Aufnahmen werden Sie jedoch deutlich hören.
Fazit
Die Entwicklung der KI-gestützten Rauschunterdrückung markiert einen technologischen Wandel – von der bloßen Entfernung von Störgeräuschen hin zum intelligenten Verständnis von Klang. Sie ermöglicht es jedem Nutzer, unabhängig vom Aufnahmeort klar und verständlich zu kommunizieren. Mit der zunehmenden Leistungsfähigkeit moderner Prozessoren wird sich die KI-Geräuschunterdrückung von einem Premium-Feature zu einem Standardmerkmal moderner drahtloser Mikrofone entwickeln.
Häufig gestellte Fragen (FAQ)
Was ist KI-Rauschunterdrückung?
KI-Rauschunterdrückung ist eine auf Deep-Learning-Modellen wie neuronalen Netzwerken basierende Technologie. Durch das Training mit umfangreichen Datensätzen kann sie menschliche Stimmen erkennen und von Umgebungsgeräuschen trennen.
Ist KI-Geräuschunterdrückung besser als ENC?
Ja. Technisch gesehen konzentriert sich ENC mit einer Geräuschreduzierung von etwa 15 dB vor allem auf gleichmäßige Hintergrundgeräusche. KI hingegen kann komplexe, nichtstationäre Störgeräusche mit einer Unterdrückung von bis zu 40 dB verarbeiten und dabei die Stimmqualität besser erhalten.
Beeinträchtigt KI-Rauschunterdrückung die Stimmqualität?
Hochwertige KI verbessert die Sprachverständlichkeit erheblich. Bei extrem hohen Unterdrückungsstufen können jedoch leichte Audioartefakte auftreten. Deshalb bleiben professionelle Aufnahmebedingungen weiterhin empfehlenswert.
Kann KI Stimmen im Hintergrund entfernen?
Ja. Fortschrittliche Sprachisolierung kann das individuelle „Stimmprofil“ eines bestimmten Sprechers erkennen und andere Stimmen im Hintergrund unterdrücken. Dies ist besonders bei Online-Meetings sehr effektiv.